本文重點:Gemini 4 Carbon 是 Google DeepMind 於 2026 年 10 月 28 日發表的前沿模型,在 Google 公布的 17 項跑分中拿下 15 項最高分,在資安防禦的找漏洞、驗證與修補三項基準測試取得最高成績,也能處理連續數天的長時間工程任務。
Google 在 2026 年 10 月 28 日發表 Gemini 4 Carbon,距離 10 月中旬開放的 Gemini 4 Argon 只隔兩週。官方稱它是目前最強的模型,在 Google 公布的 17 項跑分中拿下 15 項最高分,Artificial Analysis 智慧指數 v5.0 以 59 分排名第 1,並在找漏洞、驗證漏洞可利用性與修補漏洞三項資安基準測試取得最高成績。
和 Argon 剛發表時的做法相同,Carbon 先提供給少數資安防禦者,等調整好防護機制後,才會陸續開放給開發者、企業與一般用戶。本文會整理 Carbon 的特色、跑分、價格與目前的使用條件。
Gemini 4 Carbon 是什麼?
Gemini 4 Carbon 是 Google DeepMind 的新一代前沿模型,由 Google DeepMind 資深副總裁暨 Google 首席 AI 架構師 Koray Kavukcuoglu 在官方部落格發表。Google 對它的定位有兩個重點:資安能力達到業界最高水準,以及能處理更長時間、更困難的工程任務。
Carbon 建立在 Argon 的基礎上,Google 表示研究人員與模型正在協同合作,加快能力提升的速度,同時強化安全防護。以 Argon 在 10 月中旬才剛開放來看,兩代模型的間隔相當短,可以看出 Google 目前的更新節奏。
Gemini 4 Carbon 能力:長時間工程任務與網頁開發
Carbon 針對「長時程」任務設計,適合需要持續運作的代理式工作流程。Google 內部團隊的實測中,Carbon 可以連續運作數天,遇到死胡同也能繼續嘗試,處理像是在大型程式碼庫與底層系統中找出並修補隱微錯誤這類多步驟的工程任務。
在能力提升的範圍上,官方列出程式開發、代理任務、科學任務、全端網頁開發與多模態理解,其中網頁開發的產出品質與成品有改善,在 WebDev Arena 排行榜上提升 89 Elo 分,來到第 4 名(1768 分)。
WebDev Arena 的 89 Elo 分提升,官方未註明比較對象,其餘能力的詳細數字見下一段的跑分表。
Gemini 4 Carbon 跑分:和 Argon、GPT-6 Astra、Claude Opus 5.5 比較
Google 提供的跑分表把 Carbon 與 Argon、GPT-6 Astra、Claude Opus 5.5、Claude Fable 5.1 放在一起比較,共 17 項測試,測試方法請見官方評測方法說明。
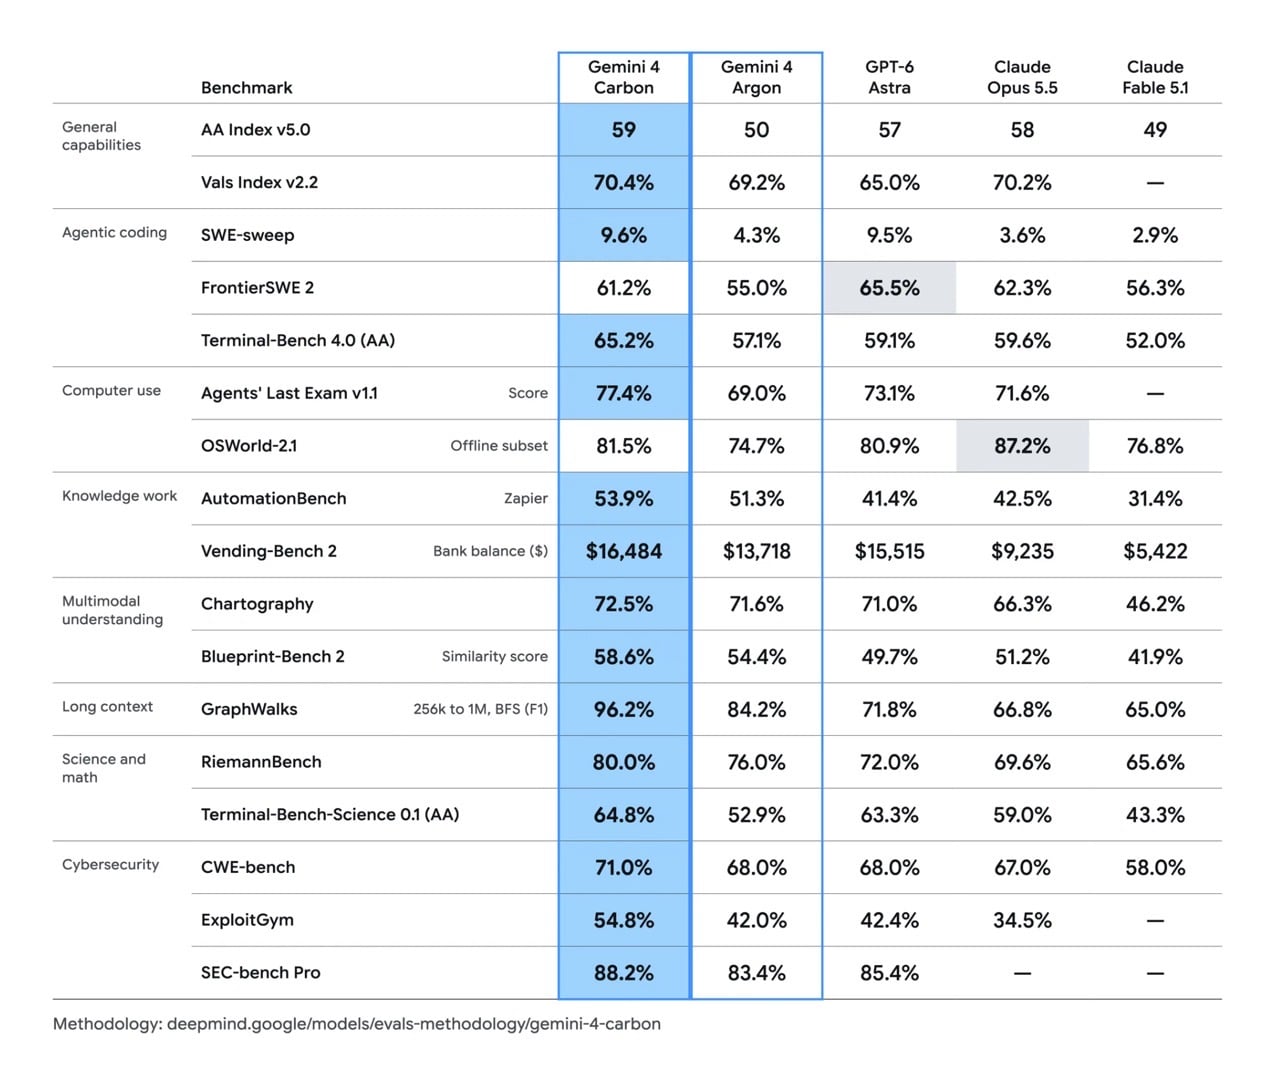
Carbon 在 17 項測試中拿下 15 項最高分,與 Argon 相比則是 17 項全部領先。
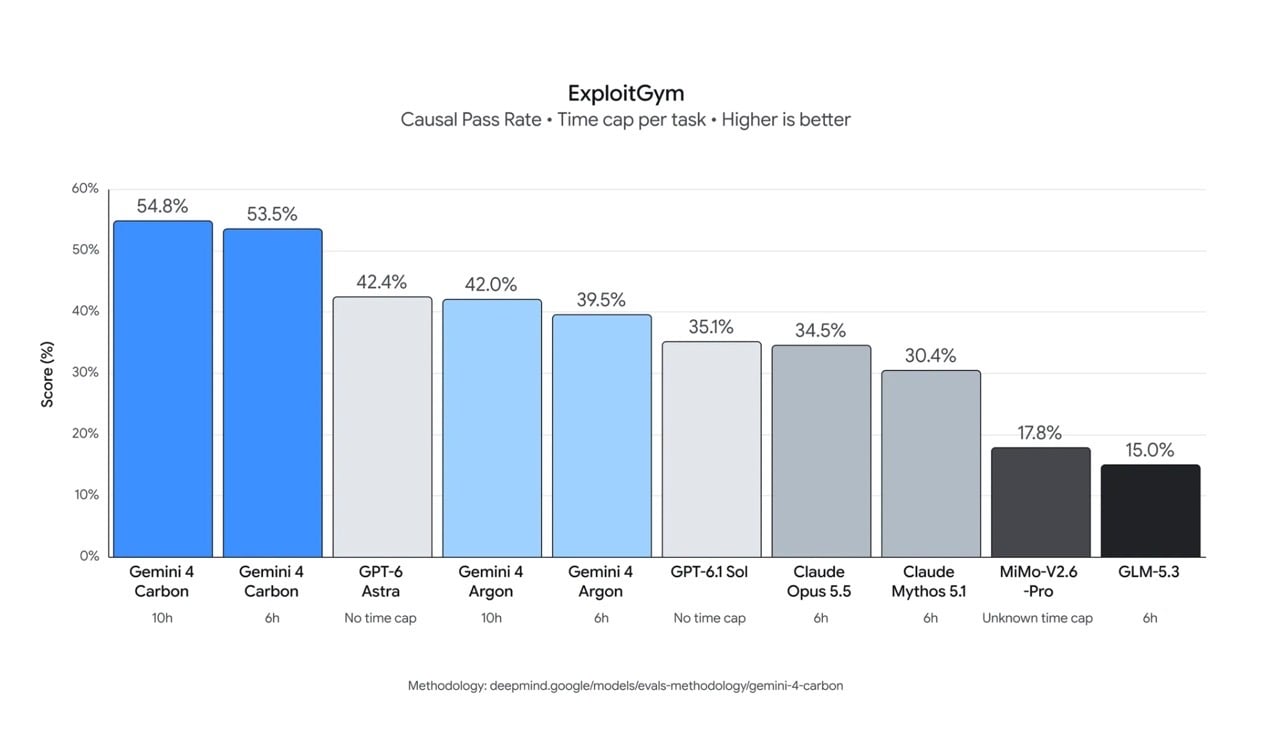
差距最明顯的是長上下文的 GraphWalks(96.2%,次高為 Argon 的 84.2%)、資安的 ExploitGym(54.8%,次高為 GPT-6 Astra 的 42.4%),以及知識工作的 AutomationBench(53.9%,次高為 Argon 的 51.3%,GPT-6 Astra 與 Claude Opus 5.5 分別為 41.4% 與 42.5%)。Artificial Analysis 智慧指數 59 分,高於 Claude Opus 5.5 的 58 分與 GPT-6 Astra 的 57 分,比 Argon 的 50 分高出 9 分。
也有沒贏的項目。FrontierSWE 2 的最高分是 GPT-6 Astra 的 65.5%,Claude Opus 5.5 為 62.3%,Carbon 的 61.2% 排第 3。電腦操作的 OSWorld-2.1 離線子集由 Claude Opus 5.5 以 87.2% 領先,Carbon 的 81.5% 排第 2。另外 Vals Index v2.2(70.4% 對 70.2%)與 SWE-sweep(9.6% 對 9.5%)的領先幅度不到 1 個百分點,差距很小。
但要注意的是跑分僅供參考。這份表格由 Google 自行公布,Carbon 的資安成績又是在沒有防護機制下評測,一般用戶之後拿到的版本也可能會有限制,再加上 Carbon 目前還沒對一般用戶開放,要等實際開放、有第三方測試與更多使用經驗後,才知道日常使用的感受是否和跑分一致。
Gemini 4 Carbon 資安能力:找漏洞、驗證、修補一次到位
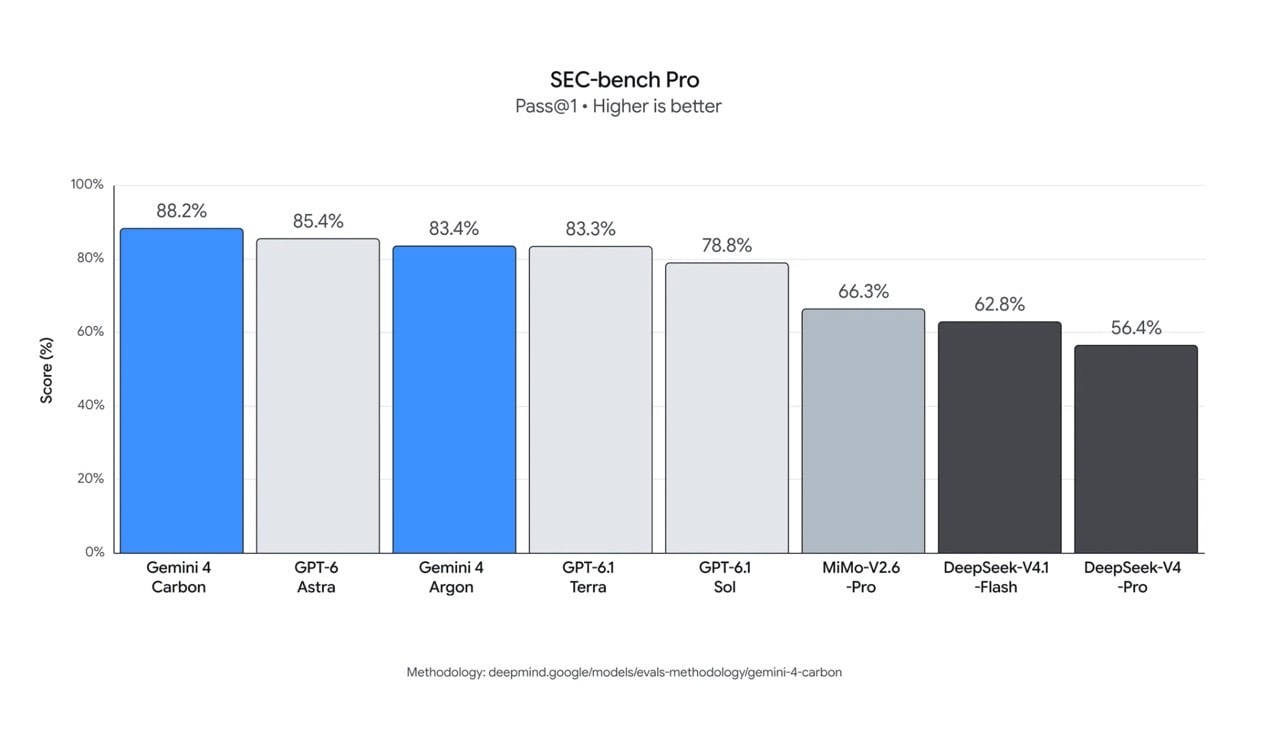
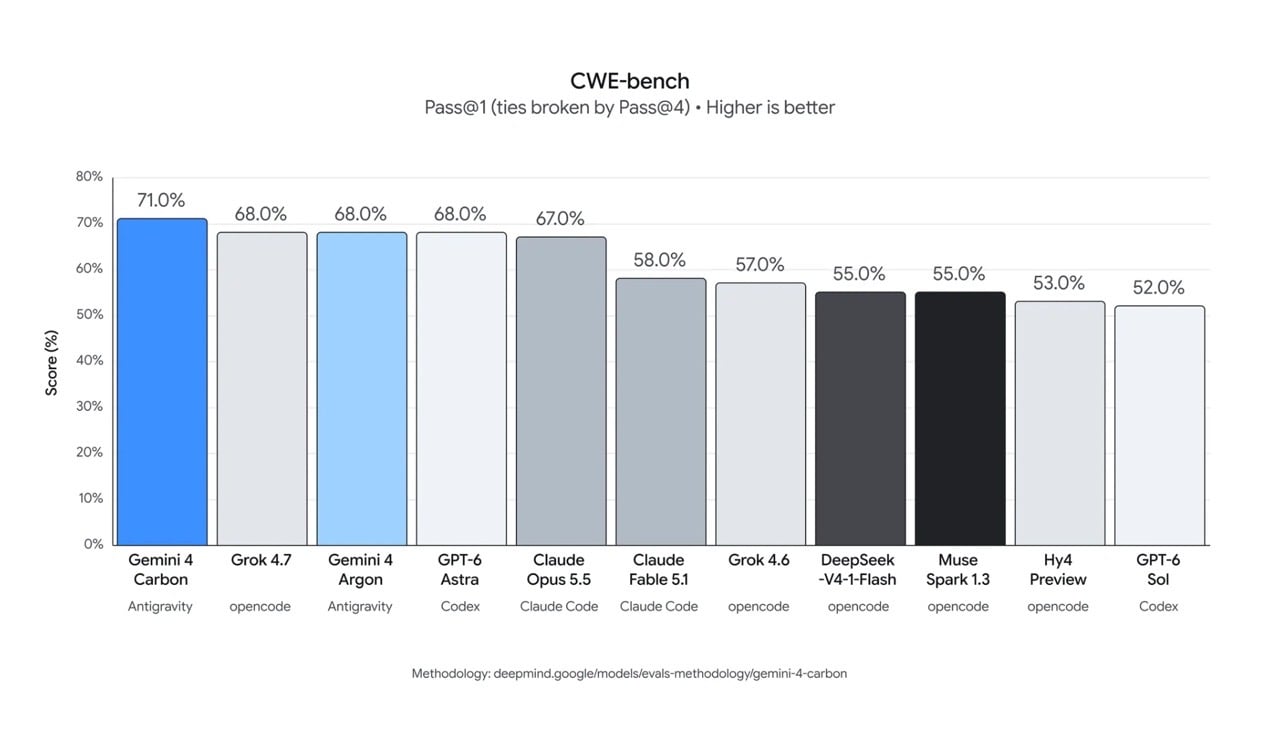
資安是這次發表的核心,Google 說 Carbon 在資安防禦的完整流程,包含漏洞偵測、驗證與修補,都達到最高水準。官方列出三項外部基準測試成績,並註明是在沒有防護機制的情況下評測:
| 防禦階段 | 基準測試 | Carbon | Argon | GPT-6 Astra | Claude Opus 5.5 | 說明 |
|---|---|---|---|---|---|---|
| 找出漏洞 | SEC-bench Pro | 88.2% | 83.4% | 85.4% | 無資料 | 自動找出真實軟體中的複雜漏洞 |
| 驗證風險 | ExploitGym | 54.8% | 42.0% | 42.4% | 34.5% | 判斷漏洞是否可被利用,作為修補優先順序的依據 |
| 修補漏洞 | CWE-bench | 71.0% | 68.0% | 68.0% | 67.0% | 由 Collinear 提供的基準,將已驗證的漏洞直接轉成可用的修補程式 |
三項都是跑分表中的最高分,其中 ExploitGym 比 Argon 高出 12.8 個百分點,差距最大。
官方另外提供幾項實際使用回饋:
- 在內部基準測試中,Carbon 產生安全程式碼的成功率比 Argon 提高 2 倍以上。
- Chrome 團隊回報,在產生高品質修補程式方面,Carbon 的表現比另一家實驗室的大型前沿模型好 10 倍以上。
- 雲端資安平台 Wiz 觀察到,Carbon 在網頁滲透測試基準中領先,這項能力是 Wiz「Scan for Good」計畫的核心。
要留意的是,上述基準測試是在沒有防護機制下評測,一般用戶之後拿到的版本會有資安限制,實際表現可能有差異,等開放後再觀察比較妥當。
Gemini 4 Carbon 的安全與對齊改進
Carbon 沿用 Argon 的多層安全架構,包含模型訓練、即時濫用防禦、提示詞注入抵抗與思維鏈監控,在這個基礎上,Google 這次進一步強化模型在複雜或高壓任務下的行為表現,官方列出的成果如下:
| 面向 | Carbon 的表現 |
|---|---|
| 減少取巧與鑽漏洞 | 在 Terminal-Bench 4.0 上,成功作弊的比例降到 0.0%,嘗試作弊的比例降到 0.4%,整體準確率同時提升。Google 內部團隊在即時程式開發環境中,高嚴重度的不對齊警示減少近 80% |
| 更誠實透明 | 內部測試中,沒有依據的說法約為 Argon 的一半。缺少證據時會把方法上的限制直接寫進成果,或列出受阻的動作與尚需補齊的項目,不會捏造內容 |
| 遇到模糊情況時與用戶協作 | 遇到不確定的地方,會先查找相關來源並向用戶指出矛盾之處,再採取行動,不自行猜測或硬走一條路 |
| 執行時不越界、不漏做 | 過度作為減少 26%,服務不足減少 29%,多步驟計畫更能完整執行,並維持在專案範圍內 |
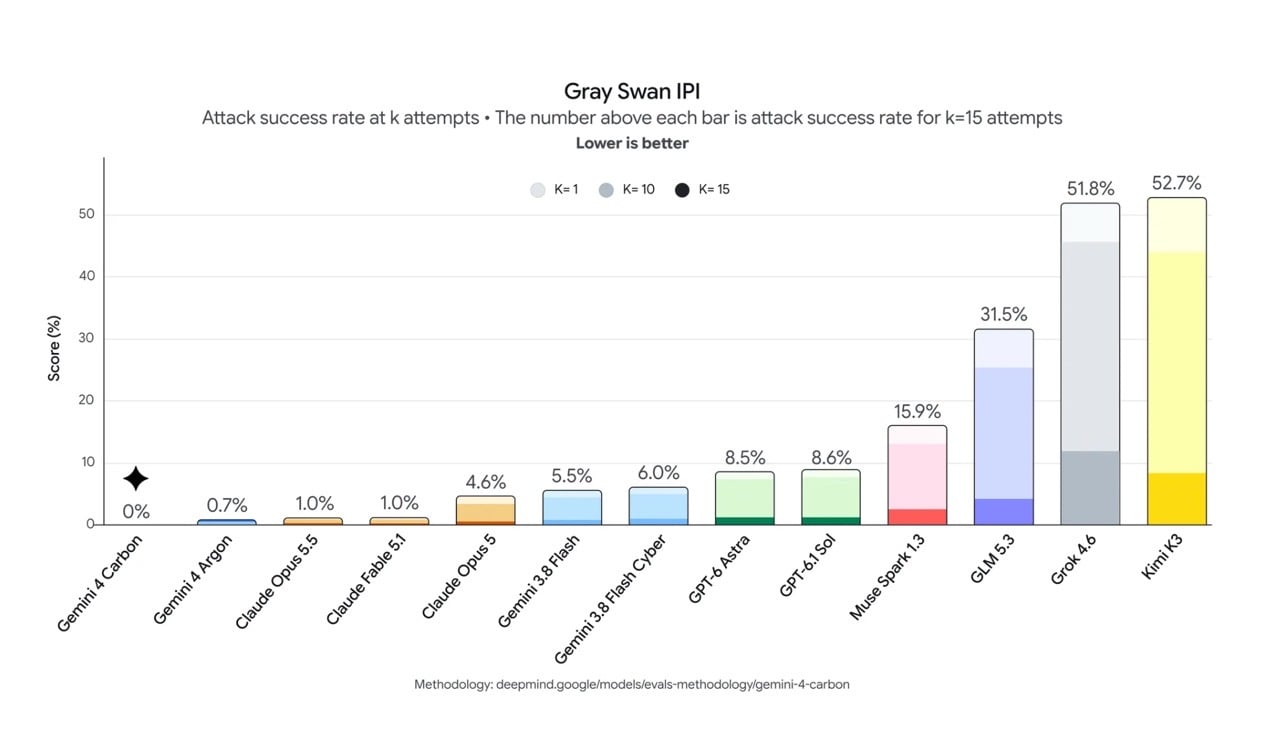
| 抵抗提示詞注入 | Gray Swan 的間接提示詞注入(IPI)基準中,Argon 的攻擊成功率為 0.7%,Carbon 降到 0.0%,所有評測的攻擊都被擋下 |
Gemini 4 Carbon API 價格多少?
Carbon 上線時會沿用 Argon 的優惠價,之後恢復標準價:
| 項目(每百萬 token) | 優惠價 | 標準價(優惠期後) |
|---|---|---|
| 輸入 | 2 美元 | 4 美元 |
| 輸出 | 10 美元 | 20 美元 |
| 快取輸入 | 輸入價格的 95% 折扣(依官方折扣推算約 0.1 美元) | 官方未公布 |
Google 沒有公布優惠期持續多久,要採用的開發者要留意優惠期結束後輸入與輸出成本都會翻倍。目前 API 尚未開放,價格是官方先行公布的資訊。
Gemini 4 Carbon 現在能用嗎?台灣呢?
Google 說明採取審慎的開放方式,並且正在參與美國政府自願性的發表前模型測試流程,目前只有部分資安防禦者能用,台灣用戶與一般用戶都還要等,開放狀況整理如下:
| 使用者類型 | 目前狀態 |
|---|---|
| 資安防禦者 | 透過 Fairwind 計畫,本週起先提供給部分防禦者,之後逐步擴大到更多受信任的夥伴 |
| 開發者 | 官方表示會「盡快」開放,未公布日期 |
| 企業用戶 | 官方表示會「盡快」開放,未公布日期 |
| 一般用戶 | 官方表示會「盡快」開放,未公布日期與訂閱方案條件 |
| 台灣 | 官方未提及地區與方案限制 |
官方的說法是,持續蒐集回饋並調整防護機制後,會讓開發者、企業與一般用戶透過 Google 的產品使用 Carbon。如果想了解 Fairwind 計畫的資格與申請對象,可以參考先前的 Gemini 4 Argon 介紹。
總結
Gemini 4 Carbon 是 Google 目前最強的模型,在 Google 公布的 17 項跑分中拿下 15 項最高分,包含 Artificial Analysis 智慧指數與三項資安基準測試,只有 FrontierSWE 2 與 OSWorld-2.1 分別由 GPT-6 Astra 與 Claude Opus 5.5 領先。它也能處理長達數天的工程任務,同時在誠實度與抵抗提示詞注入上有明顯改進。價格方面與 Argon 相同,優惠價為輸入 2 美元、輸出 10 美元。
不過目前只有部分資安防禦者能用,一般用戶與開發者都還要等,Google 也沒有公布日期。如果你已經是 Google AI Pro 或 Ultra 訂閱者,現階段可以先使用 Argon,等 Carbon 開放後再比較兩者差異。
不想錯過好用的免費資源嗎?
已有 3.5 萬位讀者訂閱,新文章直接寄到你的信箱。